Suno zette op 1 oktober Speech online: een model dat een gesproken tekst maakt met de muziek er meteen onder, in één opname. In de aankondiging noemt Suno zelf verjaardagen en bruiloften als het soort momenten waarvoor mensen nu al liedjes maken.
Dat is precies waar je op muziek maken met AI mee bezig bent. Alleen zit Speech niet in de API waar onze Studio op draait. Dus probeerden we de route die het dichtst in de buurt komt, met vier eigen teksten en tien takes. Het Nederlands bleek goed verstaanbaar. Eén getal ging twee keer mis.
Speech is now in Beta. Try the first model ever that creates spoken audio with matching background music. Update your app for the latest.
— Suno 2 oktober 2026
Twee standen en een knop voor de muziek
Speech zit in de Suno-app onder Create. Er zijn twee standen. In Simple typ je één regel, zoals "een piratenkapitein die zijn bemanning toespreekt", en Suno schrijft de tekst zelf. In Advanced plak je je eigen tekst.
Daar kies je ook een mannen- of vrouwenstem, beschrijf je de manier van spreken en zet je de achtergrondmuziek aan of uit. Dat staat in het verslag van The Verge, dat ook een maximum van ongeveer acht minuten noemt. Suno zelf noemt nergens een maximumlengte.
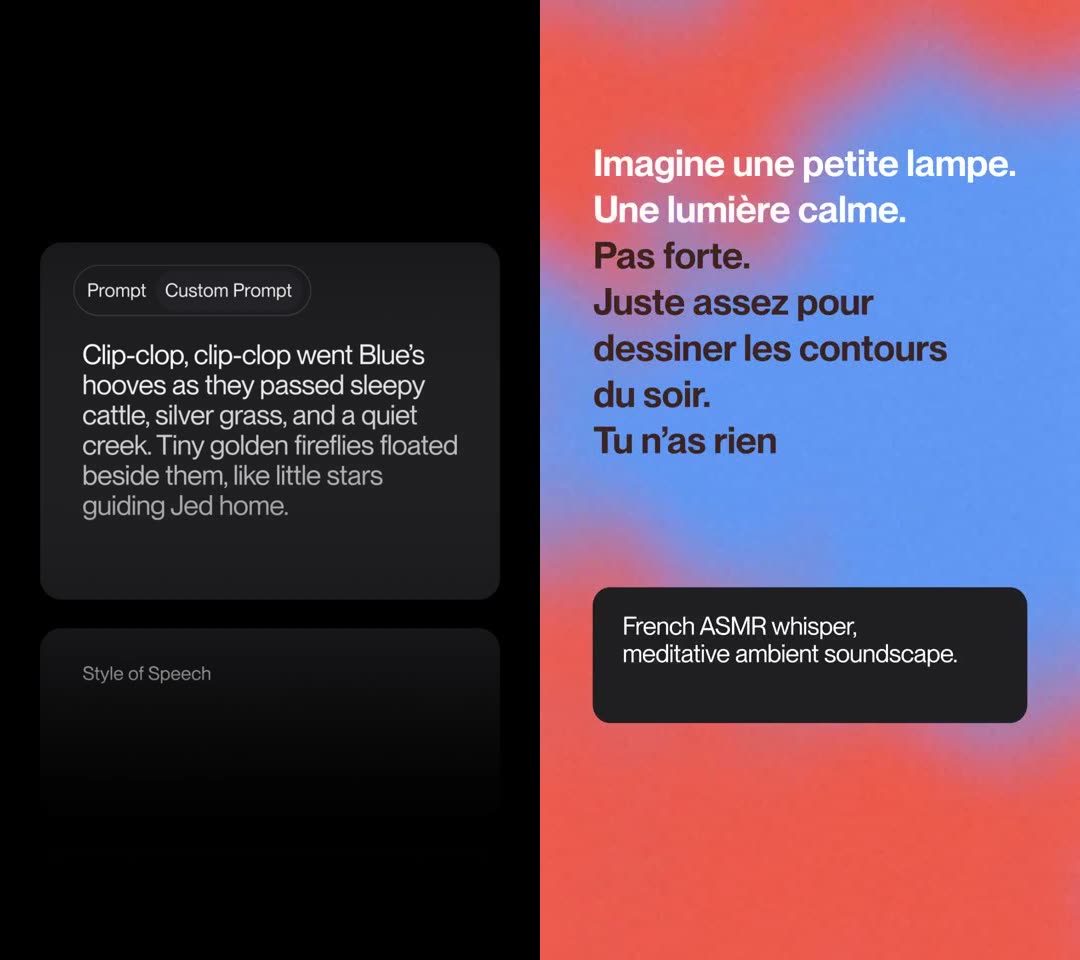
Suno is zelf eerlijk over de kwaliteit. "Beta really does mean beta", staat er. Een Brits accent kan volgens Suno even naar Australië afdwalen, en een dramatische pauze wordt soms erg dramatisch. Een taallijst ontbreekt. Dat het niet alleen Engels is, zie je wel in de lanceringsvideo: daar komt een Franse tekst voorbij.
Een aparte prijs voor Speech heeft Suno niet gepubliceerd. Een Speech-generatie gebruikt gewoon credits, net als een lied. Wat wel vaststaat, zijn de downloadregels die sinds 3 september gelden. Ze staan in Suno's blog over de nieuwe voorwaarden:
| Abonnement | Downloads | Zelf commercieel gebruiken |
|---|---|---|
| Free | Tot 7 proefdownloads als je account van vóór 3 september is. Nieuwere accounts krijgen er soms een paar. | Nee, proefdownloads niet |
| Pro | 20 per maand | Ja |
| Premier | 60 per maand | Ja |
"Songs downloaded from Suno on paid plans remain yours to use commercially or personally", schrijft Suno. Volgens een praktijkgids van Undetectr telt een Speech-download gewoon mee, net als een lied. Op een gratis account kun je dus hooguit een paar keer iets downloaden.
Waarom zit Speech niet in onze Studio?
Onze Studio maakt liedjes via de Suno-API van KIE. In die catalogus staan 23 Suno-functies, van liedjes maken tot stems en MIDI. Speech staat er niet tussen. Dat hebben we op 13 oktober nagekeken in de live catalogus en in de documentatie van KIE.
Op de deelpagina van een van Suno's eigen voorbeelden, de Odyssee in Gen Z-taal, staat de tekst gewoon met [Spoken Word] erboven. Als stijl staat er "Spoken English narration by a solo female speaker, with no instruments; casual". Het tweede voorbeeld, de afwas in Victoriaans Engels, staat op zijn deelpagina als "A classical song sung in English", met couplet en refrein.
Spreken en zingen lopen bij Suno dus door elkaar. Daarom hebben we diezelfde opbouw op het gewone liedmodel gezet: V6, de tag [Spoken Word] boven de tekst, en een stijl als "Spoken Dutch narration by a solo female speaker, over soft piano".
Tien takes, één getal dat twee keer misging
We schreven drie Nederlandse teksten die je bij ons vaak ziet: een bruiloftsspeech, een afscheidswoord voor een opa en een slaapverhaaltje. Als controle ging de bruiloftsspeech ook in het Engels. Elke opdracht leverde twee takes op en kostte 12 KIE-credits, ongeveer 6 dollarcent.
Die takes lieten we uitschrijven door Whisper (large-v3-turbo), een spraakherkenner die niet weet wat er had moeten staan. Daarna legden we dat woord voor woord naast de tekst. Gemini luisterde als tweede oor mee of het gesproken of gezongen was.
| Tekst | Woorden goed | Wat misging |
|---|---|---|
| Afscheid, 87 in cijfers | 61 van 62, twee keer | 87 allebei de keren onverstaanbaar |
| Afscheid, 87 voluit | 61 en 62 van 62 | één keer "leren" voor "leerden" |
| Bruiloft | 69 van 70, twee keer | "Heft" verstaan als "Heeft" |
| Slaapverhaal | 59 en 61 van 61 | één keer "in zijn" voor "eens een" |
| Bruiloft, Engels | alles behalve de namen | "San" en "Don", één extra "well" |
De takes duurden 34 tot 44 seconden.
Gemini beoordeelde acht van de tien takes, en in geen daarvan werd gezongen. Alle acht waren gesproken met muziek eronder: piano bij het afscheid en het slaapverhaal, akoestische gitaar bij de bruiloft.
In de pauzes tussen de zinnen zat de muziek 4 tot 15 dB onder de stem. In onze takes bleef de tekst dus goed te volgen. Na de laatste zin liep de muziek nog 2 tot 11 seconden door.
Het getal 87 ging twee keer mis. Whisper hoorde "zeventeste". Gemini maakte er "zeven getest" en "zeventien" van, ook toen we het stukje los aanboden, zonder te zeggen wat er hoorde te staan. "Zevenentachtig" hoorde geen van beide. Luister zelf:
Andere getallen gingen wel goed: "2009" in de bruiloftsspeech kwam er gewoon uit als tweeduizendnegen. Eén fout getal is te weinig voor een regel. Een Japanse maker die Speech zelf testte, @kazu_asset_life, had hetzelfde met "60 seconden" en "980 yen".
Pas toen hij de uitspraak erbij schreef, las Speech ze voor, al bleef de klemtoon daarna vreemd. Andere taal, ander model, maar wel hetzelfde soort fout.
Schrijf elk getal uit zoals je het hardop zegt
Dit kun je meteen doen, ook in je gewone liedteksten. Zet leeftijden, jaartallen en bedragen in woorden: "zevenentachtig", "vijfentwintig jaar getrouwd". Speel daarna de zin met het getal als eerste terug. Werkt het niet, verander dan één woord en laat de rest staan.
Wil je het zelf proberen met een eigen tekst? Kies in onze Studio een eigen songtekst, zet [Spoken Word] erboven en beschrijf in het stijlveld de stem en de muziek, bijvoorbeeld "rustige Nederlandse vrouwenstem die voorleest, zachte piano eronder".
Die route hebben we apart nagelopen. Onze tekstopschoning laat de tag staan. De stijlhulp maakte van die omschrijving "een Nederlandstalige voordracht door een zachte vrouwenstem" met spaarzame piano. Twee proeftakes met precies die stijl verstond Whisper op een paar woorden na, in hetzelfde tempo als de takes uit de tabel. Daarna hebben we ze zelf beluisterd: allebei gesproken, met zachte piano eronder.
Loopt de muziek na de laatste zin te lang door? Dan knip je hem op de liedpagina af met Inkorten met fade-out.
Verstaanbaar is nog niet hetzelfde als warm
Bij Engels gaf Gemini de stem een 5 voor natuurlijkheid. De twee Nederlandse bruiloftstakes kregen een 3 en een 2, met als commentaar "houterige intonatie", en bij één take een accent dat niet Nederlands klinkt.
Daar zit het echte punt. Bij een feestje lach je erom. Bij een uitvaart wil niemand een stem die net verkeerd klemtoont op de naam van opa.
Veel mensen vinden AI rond een uitvaart sowieso al lastig. In de Uitvaartbarometer van DELA (België, maart 2026) vindt 34 procent het ongepast om een afscheidsrede door AI te laten schrijven. 22 procent vindt dat wel oké. Naar een AI-stem die de rede voorleest, vroeg DELA niet. Hoe mensen daarover denken, weten we dus niet.
Laat liever een AI de muziek maken en een mens de woorden uitspreken. Lukt dat niet, omdat niemand het droog houdt of omdat de spreker in het buitenland zit, dan is dit een prima vangnet.
Voor een afscheidslied of een bruiloftslied blijft zingen de sterkere vorm. Een melodie vergeeft een vreemde klemtoon makkelijker dan een gesproken zin.
Tien takes zijn een steekproef, en wij maten niet Speech zelf
Onze test zegt iets over het gewone liedmodel met een gesproken tag, niet over Speech. Suno kan Speech net anders hebben getraind, met betere klemtoon of juist meer drama. Tien takes is ook weinig.
Whisper is een machine die soms zelf verkeerd hoort: "Heft" als "Heeft" kan net zo goed aan Whisper liggen. Gemini sprak zichzelf tegen: de ene bruiloftstake klonk volgens hem als een moedertaalspreker, de andere juist met een buitenlands accent. Behandel de cijfers dus als een eerste meting.
Ook Suno's claim dat dit "the first model ever" is, heeft niemand onafhankelijk getoetst. Op X zijn de meeste posts uitleg. Wie het echt probeerde, is wisselend. Een Japanse maker vond zijn eerste resultaat helemaal niets: Japans op beginnersniveau, schreef hij.
@GrimnirThe schreef dat hij beter uit de voeten kon met de Songs-tab dan met de Speech-tab. Dat klopt met wat wij zagen: het liedmodel kan het al behoorlijk.
Komt Speech in de API, dan kan de echte vergelijking
Zodra Speech in de catalogus van KIE staat, kunnen dezelfde vier teksten één op één naast deze takes. Dan wordt zichtbaar of Speech het Nederlands natuurlijker maakt en of 87 dan wel goed gaat. Tot die tijd zegt Suno zelf dat Speech een bèta is.
Wil je weten hoe Suno verder met Nederlands omgaat, lees dan Suno AI in het Nederlands. Wil je juist je eigen stem gebruiken in plaats van een stem van Suno, kijk dan bij AI stem.
Veelgestelde vraag: Suno Speech
Spreekt Suno Speech Nederlands?
Suno publiceert geen taallijst. In de lanceringsvideo zit een Franse tekst. Wij testten Speech zelf niet in het Nederlands, wel het gewone liedmodel met [Spoken Word]. Dat sprak goed verstaanbaar Nederlands, met een licht accent en een vlakke intonatie.
Kan ik de muziek onder Suno Speech uitzetten?
Ja. In de stand Advanced zit een schakelaar voor de achtergrondmuziek. Zonder muziek krijg je een kale voorleesstem.
Wat kost Suno Speech?
Suno noemt geen aparte prijs. Volgens praktijkgidsen telt een Speech-download mee in je gewone downloads. Een gratis account van vóór 3 september heeft tot 7 proefdownloads, een nieuwer account soms een paar. Proefdownloads mag je volgens Suno niet commercieel gebruiken.
Kan ik Speech gebruiken in de Studio van MuziekMakenMetAI.nl?
Nog niet, want Speech zit niet in de API. Wel kun je in de Studio een eigen tekst met [Spoken Word] erboven laten voordragen. In onze proef via de Studio-stijl werd het twee keer gesproken, met piano eronder. Lees ook hoe je een liedje maken met AI aanpakt met je eigen tekst.